Gemini 2.5 : raisonnement avancé et traitement de vidéos
Gemini 2.5 Pro est présenté comme le modèle le plus performant de sa famille, atteignant des performances de pointe sur les bancs d’essai de codage et de raisonnement. Selon l’annonce faite sur arxiv.org, cette nouvelle itération intègre une compréhension multimodale poussée, lui permettant désormais de traiter jusqu’à trois heures de contenu vidéo. Cette combinaison de contexte étendu, de multimodalité et de raisonnement sophistiqué permet de débloquer des flux de travail d’agents artificiels inédits.
Le modèle Pro est décrit comme un système de pensée avancé. À côté, Gemini 2.5 Flash offre d’excellentes capacités de raisonnement tout en nécessitant une fraction des ressources de calcul et une latence réduite. L’ensemble de la gamme Gemini 2.X couvre, d’après l’article, toute la « frontière de Pareto » entre la capacité du modèle et son coût, ce qui donne aux utilisateurs une flexibilité pour explorer des problèmes d’agents complexes.
Les défis de l’entraînement des modèles massifs
Ces avancées en matière de modèles ne sont pas isolées ; elles reposent sur des systèmes de calcul gigantesques. Pour former des modèles de cette envergure, les entreprises utilisent des systèmes distribués sophistiqués. Lorsqu’on parle de l’entraînement de très grands modèles, on ne parle pas d’un seul serveur. Des architectures comme Pathways, par exemple, sont conçues pour gérer la coordination sur des milliers d’accélérateurs.
Le modèle traditionnel de type SPMD (Single Program, Multiple Data) fonctionne bien tant que la tâche est uniforme : tous les accélérateurs exécutent le même programme en séquence, coordonnés par des opérations collectives comme AllReduce. Cependant, quand le travail devient hétérogène — comme dans une boucle de renforcement où un échantillonneur, un modèle de récompense et un entraîneur opèrent en parallèle et dépendent les uns des autres — ce modèle montre ses limites. Les dépendances deviennent trop complexes à gérer via un programme unique et bloquant.
Vers une coordination plus granulaire
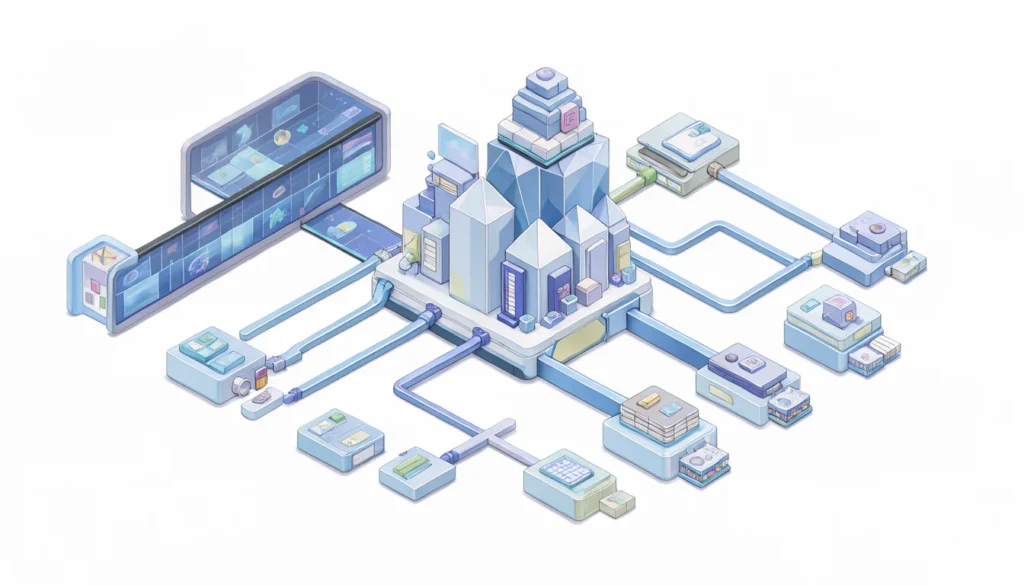
C’est là que les systèmes comme Pathways montrent leur intérêt, en visant une architecture de « contrôleur unique ». Au lieu de laisser chaque processus gérer uniquement ce qu’il voit localement, ce système modélise l’intégralité du calcul comme un graphe unique. Cela permet au runtime distribué de décider où placer chaque tenseur, comment les déplacer, et surtout, comment maintenir tous les accélérateurs actifs sans qu’un composant n’attende indéfiniment une réponse d’un autre. Les défis de la tolérance aux pannes sont également adressés ; si une machine tombe dans un environnement SPMD, tout le processus s’arrête jusqu’au dernier point de contrôle.
Les tutoriels de bas niveau, comme ceux utilisant DistributedDataParallel (DDP) dans PyTorch, montrent comment synchroniser des gradients sur plusieurs machines. Mais ces méthodes restent ancrées dans le paradigme où chaque processus exécute le même script. La transition vers une gestion de flux de travail plus complexe, où différents morceaux de code doivent s’imbriquer sans se bloquer mutuellement, est ce qui pousse l’innovation vers ces architectures plus holistiques. Il faudra surveiller comment les capacités agentiques de Gemini 2.5 vont interagir avec cette complexité d’infrastructure pour devenir réellement opérationnelles en production.
Sources
- Gemini 2.5: Pushing the Frontier with Advanced Reasoning, Multimodality, Long Context, and Next Generation Agentic Capabilities, arxiv.org
- Getting Started with Distributed Data Parallel, docs.pytorch.org
- What is Pathways? Single-controller training for large models, Google Developers Blog, 10 novembre 2026
- Cloud Pathways, a distributed ML runtime for massive accelerator fleets, now GA, Google Cloud, 9 novembre 2026