DevOps & Cloud

Tous les articles de cette rubrique.

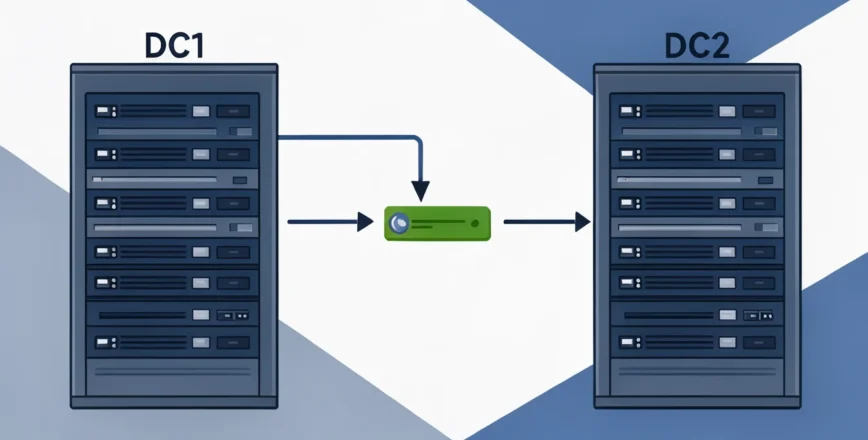
Illustration vectorielle schématique montrant la synchronisation d'infrastructure entre deux centres de données virtuels.

GitHub présente un pipeline GitOps pour AAP multi-cluster

Un dépôt GitHub vient de présenter une démonstration concrète de l’utilisation de GitOps pour gérer des configurations complexes de la plateforme Red Hat Ansible Automation Platform (AAP), en particulier lorsqu’elle est déployée sur plusieurs clusters et régions. Ce modèle découple clairement la gestion de l’infrastructure (IaC) du déclenchement des charges de travail applicatives, en utilisant GitHub Actions comme coordinateur principal.

Ce pipeline se scinde en deux phases distinctes, gérées par des branches Git séparées. Le flux vers la branche « main » se concentre sur l’infrastructure déclarative. Lorsque des modifications sont poussées dans cette branche, le workflow gitops-main.yml démarre. Il utilise des modules ansible.controller pour itérer à travers les différentes passerelles (comme AAP-Platform-DC1 et AAP-Platform-DC2) afin d’établir les réglages fondamentaux d’automatisation.

L’étape IaC consiste à synchroniser les organisations, les identifiants et les groupes. Les configurations standards de l’entreprise — incluant les mappings d’inventaire entre les environnements de production et non-production — sont gérées de manière déclarative via des variables stockées dans vars/aap_config.yml. Pour sécuriser ce processus, les secrets sensibles, tels que les clés SSH ou les URLs de Vault, sont gérés via des fichiers Vault chiffrés temporaires, un soin que les équipes de plateforme doivent prendre en compte.
Photographie nocturne d'un ordinateur portable affichant des logs de déploiement complexes, reflétant les lumières de la ville.

Le second volet, déclenché par des poussées sur la branche « deploy », est dédié au dispatching des charges de travail. Le playbook dispatch_round_robin.yml est chargé de router l’exécution des tâches vers le cluster approprié. Si la variable target_aap est définie sur « auto », le système alterne les exécutions de manière équilibrée entre les instances des clusters, en appliquant un algorithme de round-robin basé sur le numéro de l’exécution GitHub. C’est une méthode qui permet de maintenir une continuité opérationnelle sans interruption de service, même en cas de maintenance planifiée sur un site spécifique.

Cette approche structurée est une réponse directe aux problématiques de disponibilité dans les environnements d’entreprise. Red Hat mentionne que, sans ce type de fédération multi-cluster, une panne du contrôleur AAP peut effectivement paralyser les pipelines CI/CD. L’architecture présentée permet, par exemple, de dédier des workloads à DC2 pendant que des mises à jour OS sont appliquées sur les nœuds de DC1, assurant ainsi une haute disponibilité.

L’intégration de ce cadre GitOps dépasse le simple déploiement technique. D’après les développeurs Red Hat, ce système s’articule facilement avec les outils d’entreprise : ServiceNow peut initier le pipeline après approbation d’un changement, et les logs d’exécution sont acheminés vers Splunk pour une analyse centralisée. Ce niveau de traçabilité est ce qui rend le concept robuste au-delà du simple code.

Il est cependant essentiel de noter que la flexibilité des variables permet des ajustements fins en temps réel. Il est possible, via des arguments en ligne de commande, d’ignorer les valeurs par défaut — par exemple, forcer le ciblage d’un hôte spécifique ou changer le template de job — offrant une granularité que les systèmes CI/CD plus monolithiques peinent à atteindre.

Sources

Vue aérienne d'un rack de serveurs moderne sous une lumière contrastée, avec une silhouette humaine stylisée en surimpression.

Cloudflare affine ses défenses contre les bots avec les pages de défi

Le système de vérification de Cloudflare gagne en finesse en ajoutant de nouvelles modalités de pages de défi, visant à mieux discerner les requêtes automatiques sans impacter l’expérience des visiteurs légitimes. Ces pages, qui apparaissent avant l’accès au site final, sont désormais gérées par différentes actions définies lors de la création d’une règle dans le Pare-feu d’Application Web (WAF).

En substance, l’outil permet de mettre en place des « Challenge Pages » qui interceptent le trafic pour évaluer l’environnement du navigateur. Selon developers.cloudflare.com, ces défis peuvent être non-interactifs, où Cloudflare juge si le visiteur est automatisé en analysant des signaux JavaScript injectés, ou bien ils peuvent être interactifs, exigeant une action de la part de l’utilisateur.

L’entreprise pousse fortement les Managed Challenges. Ce mode dynamique permet à Cloudflare de sélectionner automatiquement le type de défi approprié en fonction des signaux reçus, ce qui, selon eux, aide à éviter les CAPTCHA classiques et réduit le temps passé par les humains à les résoudre sur l’Internet.

Photographie d'un bureau moderne au coucher du soleil, montrant un développeur concentré sur son écran d'analyse système.

Sécuriser les API sans rupture de flux

Un point technique important ressort de cette évolution : les pages de défi, en renvoyant une page HTML complète, cassent intrinsèquement les requêtes qui attendent une réponse non-HTML, comme les appels AJAX ou XHR (fetch). C’est un problème récurrent pour les applications monopages (SPA) et les intégrations d’API.

Pour pallier cela, Cloudflare recommande l’utilisation de la pré-validation Turnstile. En activant cette fonctionnalité, le widget Turnstile émet un cookie de validation persistant (le fameux cf_clearance) après une vérification humaine réussie sur une page HTML initiale. Ce cookie permet ensuite au visiteur d’interagir avec des points de terminaison API sensibles sécurisés par les règles WAF, offrant ainsi une sécurité granulaire sans forcer une réponse de page de défi disruptive.

Le contexte de la menace et la résilience des systèmes

Cette attention accrue à la vérification des utilisateurs se situe dans un contexte de menaces sophistiquées. Rappelons que l’incident impliquant les clés faibles d’eMudhra, découvert au mois d’octobre 2026, a démontré la rapidité avec laquelle des certificats frauduleux pouvaient être forgés si les mécanismes de confiance étaient compromis. Pour cette crise, Cloudflare a mis en place des mesures immédiates, y compris l’ajout de journalisation pour suivre les tentatives d’établissement de connexion utilisant ces clés faibles, documentant environ 22 000 tentatives.

Parallèlement, l’infrastructure de sécurité elle-même est scrutée à une échelle plus fondamentale. D’autres projets, comme rustls/upki, travaillent sur des infrastructures de certificats indépendantes de la plateforme, visant à garantir de manière fiable et respectueuse de la vie privée la vérification de la révocation des certificats, un besoin essentiel face à des failles critiques.

L’utilisation de ces pages de défi, notamment pour tester la confiance des visiteurs, est d’ailleurs devenue une méthode indirecte de contrôle. Lors de la crise eMudhra, Cloudflare a déployé des sondages sur une fraction de ses pages de défi, envoyant des requêtes vers des serveurs avec des certificats signés différemment pour évaluer si les visiteurs continuaient à faire confiance aux clés vulnérables.

Sources