NVIDIA, Rebellions et SK Telecom construisent des infrastructures IA souveraines
L’initiative réunissant NVIDIA, Rebellions et SK Telecom vise à bâtir en Corée du Sud des infrastructures d’inférence d’intelligence artificielle capables de traiter des modèles à très grande échelle. L’annonce, faite le 8 novembre, détaille une collaboration pour intégrer les accélérateurs R200 de Rebellions avec l’architecture MGX de NVIDIA, le tout lié via la technologie NVLink Fusion.
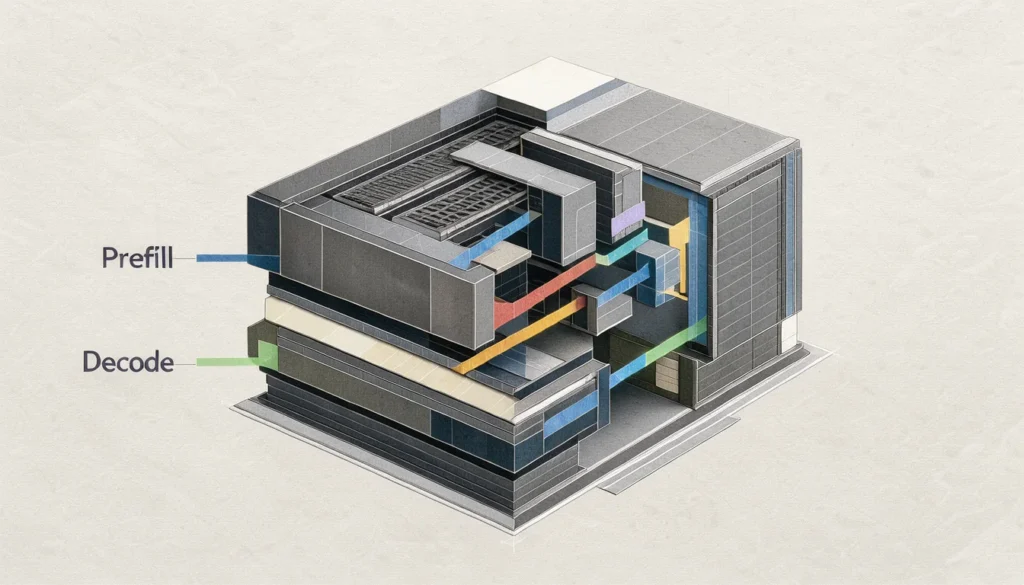
Ce projet s’inscrit clairement dans une stratégie de souveraineté IA, soutenue par le Ministère de la Science et des TIC sud-coréen. L’objectif technique majeur est d’implémenter une inférence hétérogène, c’est-à-dire de répartir la charge de travail de l’IA entre différents types de processeurs. Concrètement, les GPU de NVIDIA seraient chargés du prefill, cette phase exigeante de traitement des invites d’entrée, tandis que les NPUs (Neural Processing Units) de Rebellions prendraient le relais pour le decode, la génération itérative des jetons de sortie.
Cette séparation des tâches est intéressante car elle tire parti des forces spécifiques de chaque architecture. Le prefill, qui sollicite énormément de calcul parallèle, bénéficie des GPU, tandis que le decode met l’accent sur la faible latence et la capacité mémoire, des domaines où les NPUs sont conçus pour exceller. Les deux entreprises espèrent ainsi améliorer le débit d’inférence et l’efficacité énergétique des systèmes, surtout lorsqu’on travaille avec des modèles de langage massifs, comme les architectures mixture-of-experts (MoE) qui peuvent atteindre des téra-paramètres.
L’extension de l’écosystème NVIDIA
Pour que cette architecture hybride fonctionne, il faut un pont de haute performance. C’est là qu’intervient NVLink Fusion, une version « ouverte » de la connexion NVLink habituelle à NVIDIA. Ce connecteur permet d’intégrer des processeurs tiers – ici les R200 – dans l’environnement d’infrastructure de NVIDIA. NVIDIA ne se contente pas de fournir le socle ; il reste le pilier central, car les accélérateurs tiers nécessitent une interaction avec les composants NVIDIA.
Cette démarche n’est pas isolée. Elle confirme une tendance où NVIDIA ouvre son écosystème à des puces spécialisées. D’autres entreprises ont déjà annoncé des initiatives similaires avec NVLink Fusion. On compte notamment AWS, qui souhaite intégrer ses futurs puces Trainium4, D-Matrix avec ses Raptor-XPUs, ainsi que MediaTek et Marvell pour des accélérateurs sur mesure. L’utilisation de la référence MGX sert de base matérielle standardisée pour ces racks, définissant les gabarits, la distribution électrique et le refroidissement pour que ces configurations hétérogènes soient exploitables à l’échelle du rack.
Les enjeux de la souveraineté et du déploiement
SK Telecom apporte à la table son expertise en exploitation de centres de données d’IA, ainsi que ses modèles fondamentaux propres, comme A.X K2, en lien avec l’initiative « AI for All » du pays. Cette collaboration étend les efforts précédents entre Rebellions, Arm et SK Telecom, qui impliquaient les CPU AGI d’Arm. Sunghyun Park, cofondateur et PDG de Rebellions, a déclaré : « Aujourd’hui, cette annonce marque un tournant, ouvrant un nouveau chapitre pour l’IA souveraine en connectant le silicium et les modèles coréens avec la technologie des systèmes mondiaux. »
Le calendrier est fixé de manière ambitieuse : Rebellions vise une capacité de déploiement pour ces systèmes en 2028. Cependant, les informations précises manquent encore. Les partenaires n’ont pas communiqué la capacité totale prévue, les tarifs des systèmes, ni les benchmarks de performance chiffrés. Il reste à voir comment cette répartition des tâches se traduira réellement en termes d’optimisation matérielle, notamment concernant la gestion du cache KV et le mouvement des données entre ces différents processeurs.
| Élément | Fournisseur | Rôle dans l’architecture | Technologie clé | Objectif |
|---|---|---|---|---|
| Accélérateur de Decode | Rebellions | Génération de jetons de sortie | R200 NPU | Faible latence, Efficacité énergétique |
| Traitement Prefill | NVIDIA | Calcul des états d’entrée | GPU NVIDIA | Calcul intensif parallèle |
| Infrastructure du Rack | NVIDIA | Fondation matérielle et interconnect | MGX & NVLink Fusion | Standardisation et interconnexion |
| Opérations & Modèles | SK Telecom | Mise à disposition des services IA | Modèles propriétaires (ex: A.X K2) | Déploiement local et services publics |
Ce modèle illustre la tendance à la désagrégation des tâches dans les systèmes d’IA complexes. En laissant les processeurs se spécialiser sur ce pour quoi ils sont intrinsèquement les meilleurs – un GPU pour la puissance brute du prefill, un NPU pour la rapidité itérative du decode –, on espère atteindre une utilisation des ressources beaucoup plus fine qu’avec un système monolithique. Il faut surveiller si les détails d’implémentation, comme la cohérence de la mémoire entre GPU et NPU, permettront de concrétiser ces gains théoriques.
Sources
- NVIDIA, Rebellions and SK Telecom Target Sovereign AI, Converge Digest, 9 novembre 2026
- SK Telecom und Rebellions: Nvidia gewinnt weitere NVLink-Fusion-Abnehmer, ComputerBase, 9 novembre 2026