TPU Sync : gestion du cache KV pour accélérer l’inférence sur TPU
L’enjeu majeur de l’IA, désormais, n’est plus la puissance de calcul brute, mais la gestion de l’état du modèle en temps réel. Avec l’avènement d’agents sophistiqués capables de maintenir des conversations en plusieurs tours ou d’analyser des documents de plusieurs centaines de milliers de jetons, le goulot d’étranglement s’est déplacé vers l’orchestration de la mémoire. C’est dans ce contexte que github.com annonce TPU Sync, un nouveau framework C++ natif destiné à résoudre ces problèmes sur l’infrastructure Cloud TPU.
TPU Sync est une bibliothèque conçue pour gérer le cache clé-valeur (KV cache) et les transferts de données entre différents niveaux de mémoire. Il fonctionne comme une fondation à bas niveau, s’exécutant sous les orchestrateurs de machine learning basés sur Python. L’objectif est de permettre aux TPU de communiquer directement avec la mémoire HBM, la DRAM hôte du système et les nœuds TPU distants, en minimisant la latence et en maximisant le débit grâce à des transferts DMA (Direct Memory Access) sans copie.
Le mécanisme repose sur plusieurs innovations. Premièrement, il utilise un aliasage de mémoire zéro-copie PJRT, permettant d’accéder directement aux tenseurs JAX ou PyTorch en extrayant les descripteurs matériels natifs. Cela contourne le « saut » intermédiaire via le CPU. Deuxièmement, il dispatche les transferts volumineux et les routines réseau sur des pools de threads C++ natifs, éliminant le verrouillage du GIL (Global Interpreter Lock) de Python. Les pipelines de transfert alignés sur l’extracteur atteignent environ 200 Go/s de bande passante PCIe bidirectionnelle, selon les dimensions réelles des blocs de cache KV utilisés dans les scénarios LLM.
Gestion multi-niveaux et résilience des données
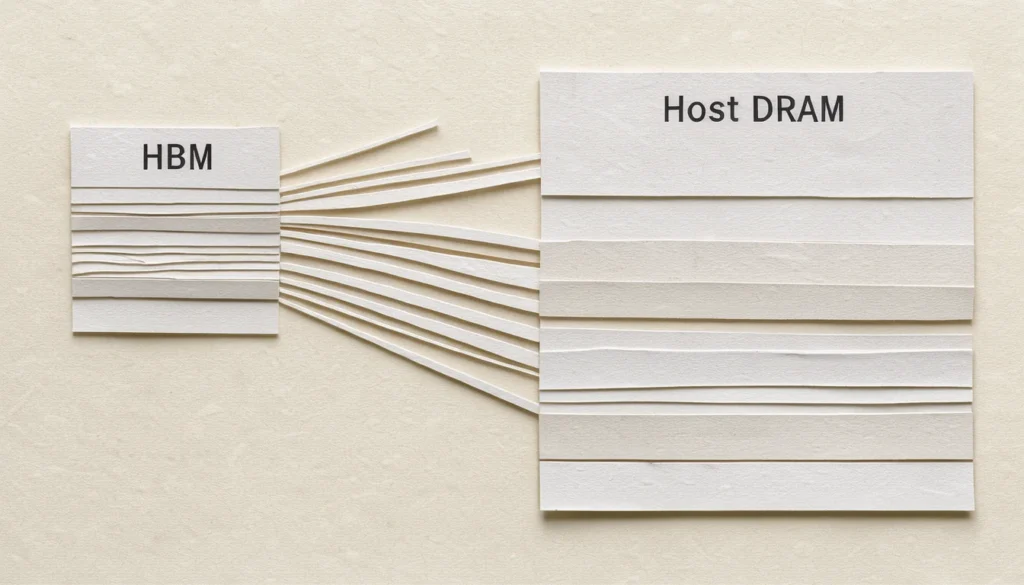
Pour gérer des contextes de plus en plus longs, TPU Sync introduit une approche en plusieurs niveaux. Il utilise la RAM du CPU hôte comme un cache préfixe ultra-rapide de « Niveau 2 ». Lorsque la mémoire HBM de l’accélérateur atteint ses limites, les blocs de KV cache sont évacués vers la DRAM hôte. Ils sont ensuite récupérés à la demande via DMA asynchrone, ce qui maximise les taux de succès pour des opérations comme le RadixAttention.
Un point notable concerne la résilience. En utilisant la mémoire partagée POSIX (/dev/shm), TPU Sync peut sauvegarder les caches KV dans la DRAM hôte. Si un conteneur d’inférence redémarre ou plante, les téraoctets de cache actifs restent intacts. Au redémarrage, le système se rattache instantanément à ce cache préchauffé, évitant la coûteuse re-computation depuis zéro.
Ce travail s’inscrit dans une tendance plus large. D’autres acteurs travaillent également sur l’optimisation des infrastructures. Par exemple, Red Hat a montré, dans ses tests sur des GPU H100 via OpenShift AI 3.5, que l’offload de l’état du cache KV vers la DRAM CPU ou des systèmes de fichiers partagés pouvait améliorer le débit jusqu’à 5,8 fois pour des charges de travail agentiques moyennes de 50 000 jetons.
Intégration dans l’écosystème ML
L’approche de TPU Sync est conçue pour s’intégrer aux outils existants. Selon Google Cloud, cette librairie sert de connecteur KV cache pour des plateformes comme vLLM et SGLang. L’intégration couvre les écosystèmes PyTorch (via TorchTPU) et JAX. Il est d’ailleurs mentionné que le projet vLLM-Torchtpu, qui permet de faire tourner des définitions de modèles PyTorch standard sur TPU sans modification de code, est compatible avec cette nouvelle architecture.
Le framework fournit également des primitives de bas niveau pour les pipelines d’apprentissage par renforcement (RL), permettant de synchroniser les poids entre les entraîneurs et les échantillonneurs avec un parallélisme hautement optimisé. Enfin, les développeurs doivent noter que le développement est très actif. L’annonce de github.com insiste sur le fait que, pour des déploiements stables, il est conseillé de « pinner » une version de libération étiquetée plutôt que de suivre directement la branche principale. Le projet est validé pour les générations Cloud TPU v7x et v6e, et il supporte plusieurs versions de JAX, comme le montre le tableau de compatibilité publié sur le dépôt.
Sources
- GitHub – google/tpu-sync, github.com
- GitHub – vllm-project/vllm-torchtpu, github.com
- Introducing TPU Sync: Fast KV cache and weight transfer for inference and RL on TPU, Google Cloud, 9 novembre 2026
- Benchmarking tiered KV cache offloading on H100 GPUs in OpenShift AI 3.5, Red Hat Developer, 2 novembre 2026
- Google and Meta Open-source TorchTPU to Bring Native PyTorch Support to Google TPUs, InfoQ, 2 novembre 2026