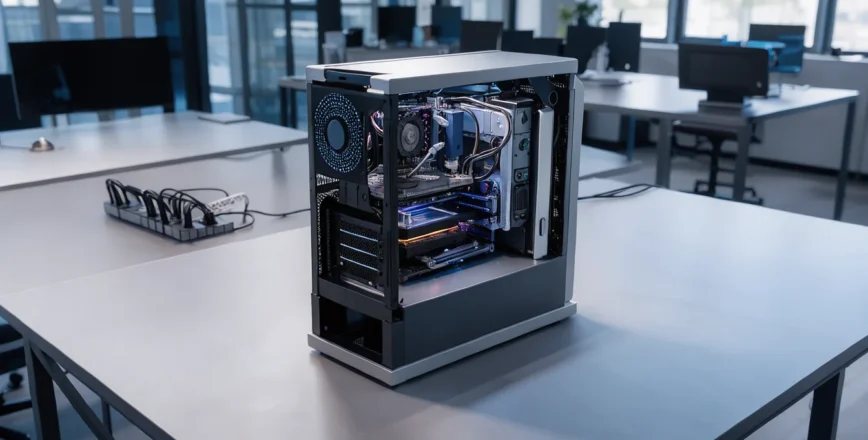
L’arrivée de la configuration DGX Spark 64GB, disponible auprès des partenaires Acer, ASUS, Dell, Gigabyte, HP et MSI, offre une plateforme de calcul personnel destinée à l’IA locale. Ce système intègre le Grace Blackwell Superchip, la mémoire unifiée, et la pile logicielle NVIDIA AI, permettant aux développeurs de tester et d’exécuter des agents d’IA directement sur la machine, éliminant ainsi la dépendance au cloud pour des tâches spécifiques. Ces unités sont prêtes à l’emploi dès le premier démarrage, supportant nativement des outils tels qu’Ollama, vLLM et PyTorch avec CUDA.
Ce superordinateur compact est positionné comme un nouveau point de départ pour l’IA personnelle. Il est capable de gérer des modèles allant jusqu’à 100 milliards de paramètres en mode local. Ce choix est intéressant dans un contexte où les modèles open source continuent de se miniaturiser pour s’adapter à des périphériques moins gourmands. D’ailleurs, le framework TensorRT Edge-LLM, conçu pour l’inférence sur les plateformes embarquées de NVIDIA, est parfaitement adapté à ce type de déploiements sur Spark, allant du Jetson Thor au DGX Spark.
Scalabilité des workloads en local
Le véritable atout de cette plateforme, c’est sa capacité à grandir sans douleur. Si un seul système ne suffit pas, deux unités DGX Spark 64GB peuvent être mises en cluster via l’assistant NVIDIA Sync Cluster Assistant. En testant le modèle Qwen 3.8 27B, deux systèmes couplés ont affiché jusqu’à 1,7 fois la performance d’une seule machine. De plus, en connectant les deux unités via un câble QSFP, on agrège la mémoire pour atteindre 128 Go et on peut supporter des modèles jusqu’à 200 milliards de paramètres, tout en doublant la bande passante mémoire. L’outil NVIDIA Sync prend en charge la configuration de ce cluster multi-nœuds de manière transparente, préservant l’environnement logiciel identique sur chaque nœud.
Cette facilité de mise à l’échelle est essentielle pour les cas d’usage réels. Un développeur peut ainsi soit faire tourner un agent de codage en continu sur une seule unité, soit utiliser le DGX Spark pour gérer l’inférence d’un modèle de génération d’images pendant que son PC personnel exécute une autre application. Il est possible d’exécuter ces modèles localement, ce qui est un avantage certain en matière de confidentialité, comme le souligne l’approche sans dépendance cloud.
Optimisation et déploiement des modèles
Au-delà de la simple exécution, la plateforme supporte des méthodes avancées d’optimisation. Par exemple, la technologie DSpark permet d’accélérer la génération de jetons grâce au décodage spéculatif. Les tests effectués sur le DGX Spark 64GB montrent que l’activation de DSpark sur des charges de travail comme HumanEval augmente la vitesse de génération en moyenne de 126,9 tokens/s, contre 73,4 tokens/s sans cette optimisation, selon les données de performance.
Pour aller plus loin dans l’application, le système offre des capacités de service. On peut lancer le modèle via une API compatible OpenAI locale sur le Spark. Avec l’interface de ligne de commande trtedge, il est possible de télécharger un modèle comme Nemotron-3.5 Lightning et de démarrer un serveur d’API en quelques commandes. Cela permet aux développeurs de prototyper des applications concrètes en attendant une intégration plus lourde.
La configuration 64GB sera disponible à partir du vendredi 23 octobre, au prix de 4 999 dollars. Le DGX Spark 64GB se trouve chez Acer, ASUS, Dell, Gigabyte, HP et MSI.
Sources
- NVIDIA DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI, blogs.nvidia.com
- GitHub – NVIDIA/TensorRT-Edge-LLM: High-performance, light-weight C++ LLM and VLM Inference Software for Physical AI, github.com
- Run AI Models for Edge Application Development with Just a Few Commands, NVIDIA, 30 octobre 2026
- The 5 essential layers of AI agent sandboxing on Kubernetes, The New Stack, 29 octobre 2026