MLflow déploie une passerelle pour gouverner les agents LLM
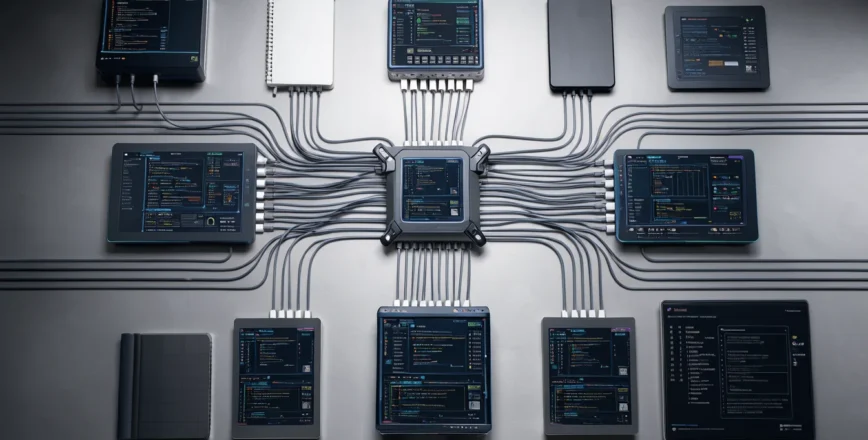
Cinq agents de codage, chacun muni de sa propre clé API, créent un désordre financier et opérationnel, ce que l’on nomme le « coding-agent sprawl » selon l’analyse de MLflow. Ce phénomène, où chaque outil gère son propre tableau de bord de consommation, rend impossible une visibilité unifiée sur les dépenses réelles. Face à ce chaos, MLflow annonce l’AI Gateway, une passerelle qui centralise le contrôle de tous les appels aux grands modèles de langage.
Le principe est simple, mais le besoin est criant. Au lieu que chaque agent (Cursor, Claude Code, Codex CLI, Gemini CLI, Pi) conserve ses propres identifiants auprès des différents fournisseurs, il pointe désormais vers un seul point d’entrée : la passerelle MLflow. Cette dernière, qui s’incorpore dans le serveur MLflow 3.15.1, ne se contente pas de router les requêtes ; elle impose des règles de conduite.
Cette architecture, qui est l’équivalent open-source de la démo « Unity AI Gateway » de Databricks, permet d’appliquer des politiques de contrôle des coûts et des gardes-fous de sécurité directement sur le chemin de la requête. Lorsqu’un agent envoie une demande, celle-ci passe d’abord par des vérifications, notamment la détection de données personnelles identifiables (PII) avant même d’atteindre le modèle.
Contrôle des coûts et sécurité en amont
L’un des problèmes majeurs soulevés par le sprawl est la fuite de données et le risque de dépassement budgétaire incontrôlé. Un agent coincé dans une boucle de réessai peut consommer des milliers de jetons en quelques heures ; quand la facture arrive, le responsable n’est plus identifié. L’AI Gateway résout cette problématique en transformant l’endpoint — et non plus l’agent — en l’unité de gouvernance. Il est possible d’y greffer des politiques de budget, comme un seuil de rejet fixé à environ 0,05 $ par jour, qui renvoie un code 429 si le plafond est dépassé.
En matière de sécurité, la passerelle agit en double couche. Elle applique une détection PII avant le LLM (blocage en amont) et une vérification de sécurité après la génération du contenu (blocage en aval). Cela permet, par exemple, de détecter si un modèle, même bien prompté, génère en retour un fichier de configuration contenant une adresse email sensible. Les traces sont ensuite conservées pour chaque appel, taguées par agent, fournisseur et endpoint, offrant enfin l’attribution que l’on ne possédait pas auparavant.
Uniformisation des appels aux modèles
Techniquement, la passerelle agit comme un traducteur. Elle normalise les requêtes, même si elles proviennent de différents systèmes (OpenAI, Anthropic ou Google), pour qu’elles correspondent au schéma de chat-completions d’OpenAI. Les agents n’ont donc pas besoin de connaître la complexité des multiples API externes ; ils pointent simplement vers l’URL de la passerelle avec un base_url spécifique.
Les agents sont ensuite dirigés vers des endpoints spécifiques configurés dans l’interface MLflow : par exemple, les agents Cursor et Claude Code utilisent l’endpoint dbx-claude-endpoint, tandis que ceux utilisant Gemini CLI et Pi sont routés vers dbx-gemini-endpoint. Ce mécanisme d’adressage est la clé de la gestion centralisée. L’approche permet, selon les démonstrations illustrées dans le notebook d’exemple, de vérifier rapidement si tous les points de connexion fonctionnent, de lancer des scénarios de charge contrôlés, et d’observer le flux complet de la requête.
Pour mettre cela en place, il faut d’abord configurer les connexions LLM dans l’interface MLflow, puis créer les endpoints correspondants. Le routage est précis : Codex CLI passe par dbx-codex-endpoint, tandis que Gemini CLI et Pi sont dirigés vers dbx-gemini-endpoint. L’ensemble est accessible via une interface compatible OpenAI, en pointant simplement le base_url vers la passerelle locale.
Il faudra surveiller comment cette consolidation des outils va impacter les stratégies de déploiement d’agents plus complexes, surtout si d’autres plateformes, comme Amazon Bedrock AgentCore, proposent également des mécanismes de contrôle de flux pour leurs propres environnements agentiques.
Sources
- mlflow-genai-tutorials/ai_gateway_governance/README.md at main · dmatrix/mlflow-genai-tutorials, github.com
- Governing Coding-Agent Sprawl with MLflow AI Gateway, MLflow, 3 novembre 2026
- Building an Agentic AI Platform on Amazon Bedrock AgentCore, AWS, 28 octobre 2026
- Fast Code, Slow Feedback: Fixing CI for the Age of AI Agents, DevOps.com, 3 novembre 2026