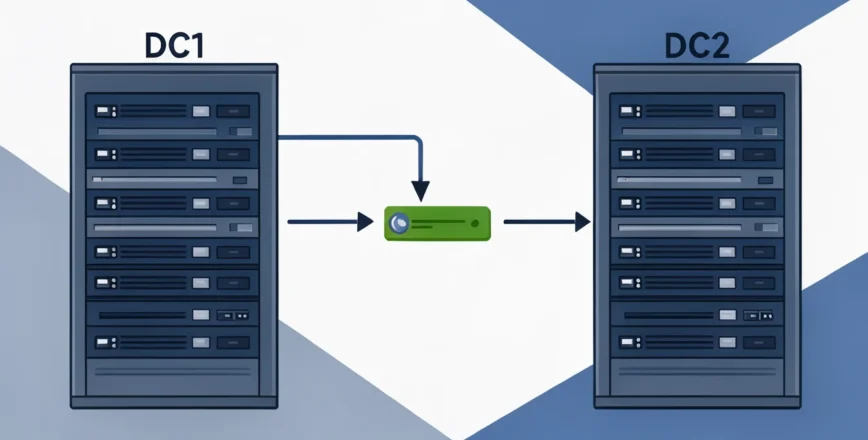
Un dépôt GitHub vient de présenter une démonstration concrète de l’utilisation de GitOps pour gérer des configurations complexes de la plateforme Red Hat Ansible Automation Platform (AAP), en particulier lorsqu’elle est déployée sur plusieurs clusters et régions. Ce modèle découple clairement la gestion de l’infrastructure (IaC) du déclenchement des charges de travail applicatives, en utilisant GitHub Actions comme coordinateur principal.
Ce pipeline se scinde en deux phases distinctes, gérées par des branches Git séparées. Le flux vers la branche « main » se concentre sur l’infrastructure déclarative. Lorsque des modifications sont poussées dans cette branche, le workflow gitops-main.yml démarre. Il utilise des modules ansible.controller pour itérer à travers les différentes passerelles (comme AAP-Platform-DC1 et AAP-Platform-DC2) afin d’établir les réglages fondamentaux d’automatisation.
L’étape IaC consiste à synchroniser les organisations, les identifiants et les groupes. Les configurations standards de l’entreprise — incluant les mappings d’inventaire entre les environnements de production et non-production — sont gérées de manière déclarative via des variables stockées dans vars/aap_config.yml. Pour sécuriser ce processus, les secrets sensibles, tels que les clés SSH ou les URLs de Vault, sont gérés via des fichiers Vault chiffrés temporaires, un soin que les équipes de plateforme doivent prendre en compte.
Le second volet, déclenché par des poussées sur la branche « deploy », est dédié au dispatching des charges de travail. Le playbook dispatch_round_robin.yml est chargé de router l’exécution des tâches vers le cluster approprié. Si la variable target_aap est définie sur « auto », le système alterne les exécutions de manière équilibrée entre les instances des clusters, en appliquant un algorithme de round-robin basé sur le numéro de l’exécution GitHub. C’est une méthode qui permet de maintenir une continuité opérationnelle sans interruption de service, même en cas de maintenance planifiée sur un site spécifique.
Cette approche structurée est une réponse directe aux problématiques de disponibilité dans les environnements d’entreprise. Red Hat mentionne que, sans ce type de fédération multi-cluster, une panne du contrôleur AAP peut effectivement paralyser les pipelines CI/CD. L’architecture présentée permet, par exemple, de dédier des workloads à DC2 pendant que des mises à jour OS sont appliquées sur les nœuds de DC1, assurant ainsi une haute disponibilité.
L’intégration de ce cadre GitOps dépasse le simple déploiement technique. D’après les développeurs Red Hat, ce système s’articule facilement avec les outils d’entreprise : ServiceNow peut initier le pipeline après approbation d’un changement, et les logs d’exécution sont acheminés vers Splunk pour une analyse centralisée. Ce niveau de traçabilité est ce qui rend le concept robuste au-delà du simple code.
Il est cependant essentiel de noter que la flexibilité des variables permet des ajustements fins en temps réel. Il est possible, via des arguments en ligne de commande, d’ignorer les valeurs par défaut — par exemple, forcer le ciblage d’un hôte spécifique ou changer le template de job — offrant une granularité que les systèmes CI/CD plus monolithiques peinent à atteindre.
Sources
- GitHub – jopaik/aap-gitops-lac, github.com
- Federated multi-cluster Ansible Automation Platform with GitOps, Red Hat Developer, 30 octobre 2026