NVIDIA a rendu disponible Nemotron 3.5 Transcribe, un modèle de transcription open-weight qui transforme l’enregistrement audio en texte exploitable, en intégrant la reconnaissance vocale, l’attribution des locuteurs, la traduction et la réponse aux questions audio en un seul point de contrôle. Ce modèle gère la transcription de 40 langues, traduit 31 d’entre elles vers ou depuis l’anglais, et identifie les locuteurs dans 13 langues. Il peut traiter des enregistrements allant jusqu’à une heure et étiqueter jusqu’à huit intervenants.
Le besoin de transcrire ne se limite plus à capturer les mots. Les réunions multilingues, les dictées médicales ou les appels rapides exigent des formats de sortie spécifiques : une traduction, des étiquettes de locuteur, ou une orthographe médicale précise. Nemotron 3.5 permet aux développeurs de guider ce résultat grâce à des instructions en langage naturel. On peut demander au modèle, par exemple : « Transcrivez cet enregistrement et étiquetez chaque orateur », ou « Traduisez cet audio en anglais ».
Ce modèle se distingue par ses performances mesurées. Sur le classement Open ASR de Hugging Face, il est le premier modèle open-weight pour l’anglais, affichant un taux d’erreur de mots (WER) moyen de 5,33 %. De plus, selon Artificial Analysis, il atteint un AA-WER de 2,8 % avec environ quatre milliards de paramètres actifs, ce qui le place sur la frontière de Pareto de l’exactitude par rapport aux paramètres utilisés.
L’adaptation par le pipeline Granary v2
Au-delà de la reconnaissance brute, NVIDIA a déployé Granary v2. Ce pipeline de données multilingues, disponible sur Hugging Face et ModelScope, permet une adaptation poussée du modèle. En utilisant les outils de réglage fin NeMo Speech, les développeurs peuvent définir la forme écrite exacte souhaitée. Une étude de cas médicale a montré que le taux d’erreur de mots a été réduit de 45,8 % en réglant le modèle sur des données spécifiques.
Le modèle permet également d’intégrer des connaissances contextuelles avant l’entraînement. Dans un contexte de santé, par exemple, un développeur peut spécifier : « Transcrivez cette discussion médicale dans sa langue originale. Termes possibles : HbA1c, metformin. Utilisez ces termes uniquement si l’audio les soutient. Préservez l’orthographe médicale standard. »
Performances sur les benchmarks spécialisés
En ce qui concerne l’attribution des locuteurs, Nemotron 3.5 se classe premier parmi les modèles open-weight sur le benchmark DAI-ASR-I18N de David AI. Il est également en tête sur le classement de VoiceArena pour la comparaison des systèmes. Pour les enregistrements longs, le modèle gère des sessions allant jusqu’à une heure.
Le modèle peut produire différents résultats à partir d’un même fichier – transcription, traduction ou réponse à une question sur le contenu. Cependant, comme pour tout système de traitement du langage, il est nécessaire de vérifier manuellement les noms propres et les changements de locuteurs avant toute intégration en production.
GitHub Copilot Fusion est désormais disponible. Au lieu de choisir un modèle spécifique pour chaque tâche de codage, les développeurs peuvent sélectionner Copilot Fusion et laisser l’outil router et orchestrer intelligemment les modèles nécessaires. Ce système combine l’orchestration de Project HydraFusion avec la sélection fine des modèles de Copilot, visant à équilibrer performance et efficacité des coûts.
En sélectionnant Copilot Fusion, l’utilisateur ne choisit pas un modèle unique. Il opte pour un système qui gère le routage pour chaque requête. Il n’est plus nécessaire de basculer manuellement entre les modèles ou de décider quel modèle convient à chaque étape. Pour chaque prompt, Copilot Fusion détermine quels modèles utiliser et comment ils doivent collaborer, laissant à l’utilisateur le choix du niveau d’effort requis.
Ce système propose trois niveaux d’effort : Fusion Standard, qui privilégie les modèles polyvalents pour le codage quotidien ; Fusion High, axé sur les modèles capables pour les tâches plus complexes ; et Fusion Max, qui utilise les modèles les plus performants pour les raisonnements les plus exigeants.
Les workflows d’exécution sont également modulables. Le mode « Single » utilise un seul modèle pour résoudre la tâche. Le mode « Cascade » permet à un modèle efficace de rédiger une ébauche, puis un contrôle qualité décide de l’accepter ou de l’escalader vers un modèle plus puissant. Enfin, le mode « Critique » implique qu’un modèle rédige une première réponse, tandis qu’un autre la révise avant que le premier ne la modifie.
Les résultats en termes d’efficacité sont notables. Selon GitHub, Copilot Fusion Max a obtenu un score de 60 dans l’Artificial Analysis Coding Agent Index, se rapprochant de Claude Code avec Opus 5.5 Max, qui est à deux points. Ce résultat est atteint avec des coûts API environ deux fois inférieurs par tâche, utilisant la moitié des jetons et nécessitant environ 40 % de temps en moins.
L’optimisation des dépenses est déjà observée sur le terrain. Hari Pokhrel, ingénieur logiciel principal chez AT&T, a souligné que « Copilot Fusion Standard a amélioré l’efficacité des jetons chez AT&T en sélectionnant automatiquement le bon modèle pour la tâche, réduisant les dépenses inutiles et préservant la capacité pour des travaux de plus haute valeur » (Hari Pokhrel, AT&T). Avant, les développeurs avaient tendance à sur-utiliser les modèles puissants pour des tâches simples, ce que Copilot Fusion élimine en gérant cette friction.
L’administration de ce système est fine. Les administrateurs peuvent définir quels modèles Copilot Fusion est autorisé à utiliser au sein de leur organisation. Ils peuvent même désactiver certains modèles pour Fusion sans retirer leur disponibilité pour tous les autres utilisateurs.
La facturation s’applique pour chaque modèle utilisé par Copilot Fusion, au tarif standard de ce modèle. Néanmoins, pour une période limitée, les utilisateurs abonnés à Copilot bénéficient d’une réduction de 30 % sur ces coûts.
Copilot Fusion est accessible dans Visual Studio Code, l’application GitHub Copilot, le CLI de GitHub et les IDE JetBrains. Il suffit de mettre à jour son client, de sélectionner Copilot Fusion dans le sélecteur de modèle et de choisir un niveau d’effort pour commencer à tester cette gestion automatisée des modèles.
Deux failles critiques dans PHP, CVE-2026-109618 et CVE-2026-109619, sont désormais cataloguées par la CISA comme étant activement exploitées, ce qui impose une réaction immédiate aux administrateurs système. Ces vulnérabilités permettent une exécution de code à distance (RCE) sans nécessiter d’authentification préalable. Palo Alto Networks, par exemple, a relevé la présence de plus de 22,6 millions d’instances potentiellement exposées à ces problèmes.
Le cœur du problème réside dans la gestion des erreurs liées à la mémoire en PHP. Concernant CVE-2026-109618, le mécanisme de sortie d’erreur en cas de dépassement de mémoire (OOM) via longjmp() laisse la mémoire de la requête dans un état non initialisé. Cela permet, selon les analyses de GitHub, à un attaquant de déclencher cet état pour exécuter des commandes. Un mécanisme similaire, au sujet de CVE-2026-109619, est au rendez-vous : un état global de la mémoire peut pointer vers des régions récemment libérées, permettant à des requêtes ultérieures de lire ou d’utiliser cet état obsolète.
Ces failles, toutes deux notées au CVSS 9,2, ne sont pas de simples problèmes de déni de service ; elles ouvrent la porte à une prise de contrôle complète du serveur. Des acteurs malveillants ont déjà réussi à chaîner ces failles PHP2Shell avec des vulnérabilités d’escalade de privilèges du noyau Linux, permettant d’atteindre le statut root, comme l’a rapporté Dream Research.
Ce qui est touché et la gravité réelle
Ce qui est touché, ce sont les applications hébergées sur des serveurs utilisant PHP, et plus spécifiquement les interfaces de gestion exposées à l’extérieur. Bien que les bonnes pratiques dictent de ne pas exposer ces interfaces à l’Internet, le fait qu’elles puissent l’être rend la portée globale. Palo Alto Networks indique que, même si seule une infime fraction de leur base installée dispose d’interfaces de gestion accessibles publiquement, c’est dans ces cas précis que le risque est maximal.
Le constat de la CISA est sans appel : le statut « exploitée activement » signifie que les outils d’attaque circulent déjà. On doit considérer que toute installation vulnérable est, en ce moment, un risque actif. Les failles sont validées sur des configurations standards, ce qui signifie que la porte est ouverte dès que la configuration de sécurité de base est contournée.
Que faire maintenant
L’unique mitigation complète, selon le rapport de GitHub, est de mettre à jour immédiatement vers une version de PHP qui contient le correctif. C’est une instruction claire, mais la mise à jour n’est pas toujours possible dans un environnement contraint. Dans ce cas extrême, une suggestion est de régler administrativement la limite de mémoire (memory_limit=-1) pour supprimer les limites prévisibles qui facilitent le déclenchement contrôlé de l’OOM, bien que ce ne soit qu’un pansement. De plus, il est conseillé d’appliquer des contrôles en amont : limiter la taille des requêtes multipart, réduire la profondeur d’imbrication des champs, et bloquer ces requêtes au niveau de la couche frontale avant qu’elles n’atteignent PHP.
Il est impératif de retirer tout accès Internet public aux interfaces de gestion. Si votre organisation utilise des solutions de sécurité comme Cortex XDR, les équipes de chasse aux menaces proposent des requêtes XQL pour surveiller les signes d’exploitation en cours.
Les agences fédérales américaines ont une échéance fixée au 29 octobre 2026 pour appliquer les mesures requises. Il faudra surveiller attentivement les prochaines annonces concernant les versions corrigées spécifiques à chaque SAPI, car la susceptibilité varie selon l’environnement d’exécution.
Des attaquants exploitent activement deux vulnérabilités critiques dans les services VPN des pare-feu Cisco ASA et FTD. Ces failles permettent à des acteurs externes de faire planter les dispositifs par déni de service (DoS) sans nécessiter aucune authentification préalable. Cisco a publié des correctifs pour ces problèmes, qui ciblent le service SSL VPN d’accès à distance.
La première faille, référencée sous le CVE-2026-20349, est apparue en août. Elle résulte d’une insuffisance de contrôle d’erreurs lors du traitement des requêtes HTTP. En envoyant une requête HTTP spécialement conçue, un attaquant peut forcer le redémarrage inattendu de l’appareil. Selon les données CISA KEV, cette faille est exploitée activement et affiche un score CVSS de 8,6. Plus récemment, Cisco a corrigé le CVE-2026-76418. Celle-ci est plus spécifique : elle tire son origine d’erreurs logiques affectant les groupes de tunnels configurés avec une authentification secondaire. L’exploitation nécessite que le pare-feu soit vulnérable, que le service SSL VPN soit accessible et que la configuration spécifique soit en place. Là encore, un attaquant peut provoquer un arrêt du service.
Ce qui est touché et la gravité réelle
Il faut bien comprendre que ces failles ne sont pas de simples problèmes de logique applicative. Elles mettent en jeu directement la disponibilité du service. Pour le CVE-2026-20349, l’exploitation est purement à distance et ne requiert aucune identification valide. De même, pour le CVE-2026-76418, Cisco précise qu’« un succès de connexion VPN n’est pas nécessaire pour atteindre le chemin de traitement affecté », ce qui souligne le caractère critique de ces portes d’entrée non sécurisées. Ces failles sont donc des vecteurs directs de paralysie pour les infrastructures.
Cisco a confirmé que ses offres en cloud – Secure Access et Secure Firewall Management Center – ne sont pas concernées par ces failles, ce qui permet de délimiter le champ d’action des équipes de sécurité. Néanmoins, l’impact sur un périmètre réseau est maximal : le service VPN, souvent la passerelle principale vers les employés distants, est mis hors service.
Que faire maintenant
La recommandation de Cisco est claire et non négociable : les clients doivent migrer immédiatement vers les versions logicielles corrigées. Contrairement à d’autres failles, aucune solution de contournement n’est disponible pour ces deux CVE. Les seuls moyens mentionnés par le fournisseur pour réduire l’exposition sont temporaires et conditionnels aux paramètres des groupes de tunnels, comme désactiver la liste des groupes de tunnels ou supprimer l’authentification secondaire, mais l’éditeur avertit que cela affaiblit la sécurité du VPN distant.
L’action requise passe par la mise à jour vers les versions spécifiées dans les avis de sécurité. Par exemple, pour l’ASA, les versions 9.16.4.103 ou ultérieures sont mentionnées comme incluant le correctif. Surveiller l’évolution de ces vulnérabilités reste de mise, car l’existence d’une seconde faille DoS dans les mois qui suivent rappelle une exposition continue des équipements de sécurité.
L’Agence américaine de cybersécurité et d’infrastructure (CISA) a ajouté deux failles de sécurité à son catalogue des vulnérabilités activement exploitées (KEV Catalog) le 28 octobre 2026. Il s’agit de CVE-2026-41709, affectant Broadcom VMware ESX, et de CVE-2026-46300, touchant le noyau Linux. Ces ajouts ne sont pas de simples mises en garde ; ils confirment que des acteurs malveillants utilisent déjà ces faiblesses en production.
La vulnérabilité dans VMware ESX, qualifiée de manque de journalisation (insufficient logging), permet à un administrateur malveillant d’exécuter certaines opérations sans qu’elles soient enregistrées. CISA confirme que cette faille, CVE-2026-41709, est activement exploitée. D’ailleurs, The Hacker News rapporte que CrowdStrike avait révélé que des acteurs liés à la Chine, nommés Warp Panda, avaient déjà militarisé cette vulnérabilité contre des entités du secteur juridique américain. Broadcom avait d’ailleurs publié un avis de sécurité en juillet 2026 concernant cette faille, mais l’intégration au KEV Catalog marque le passage de la théorie à l’action menée par les attaquants.
Les enjeux techniques des failles ajoutées
Au-delà de l’incident ESX, l’ajout de CVE-2026-46300 soulève des préoccupations bien différentes, touchant au cœur du système d’exploitation Linux. Cette faille concerne un problème dans la gestion des fragments de paquets (skb) au niveau du noyau. En substance, le mécanisme de coalescence des fragments ne préserve pas un marqueur essentiel, ce qui peut conduire à ce que le protocole ESP déchiffre des fragments stockés dans le cache de pages de manière inopinée. Les données techniques indiquent que cette vulnérabilité peut être enchaînée avec CVE-2026-109618 et CVE-2026-109619 pour implanter des webshells PHP et exécuter des commandes avec les droits root.
Les exigences de CISA, renforcées par la Directive Opérationnelle Contraignante (BOD) 26-04, sont claires pour les agences fédérales américaines : elles doivent prioriser la correction de ces failles exposées publiquement. Pour CVE-2026-41709, l’échéance pour ces entités est fixée au 11 novembre 2026. Bien que la vulnérabilité ESX ait été signalée par des chercheurs, l’exploitation observée impose un changement radical dans la gestion des actifs.
Que faire maintenant
Pour les organisations qui ne sont pas sous la juridiction fédérale américaine, l’appel à l’action est tout de même pressant. CISA encourage toutes les entités à adopter une gestion des vulnérabilités basée sur le risque. Il ne suffit plus de suivre les cycles de patchs planifiés ; il faut évaluer activement l’exposition de chaque actif. En ce qui concerne VMware ESX, les utilisateurs doivent appliquer les correctifs fournis par Broadcom, tout en se conformant aux directives de CISA concernant la traçabilité post-exploitation. Pour le noyau Linux, la mise à jour des versions concernées est la voie principale, mais il faut surveiller attentivement les chaînes d’exploitation potentielles mentionnées.
La responsabilité incombe aux équipes opérationnelles de déterminer non seulement si elles possèdent ces systèmes, mais surtout si ces systèmes sont accessibles depuis l’extérieur. Surveiller les mises à jour des fournisseurs et se préparer à une réévaluation complète des surfaces d’attaque exposées semble être la seule réponse viable face à cette vague de vulnérabilités validées par l’usage réel.
import boto3
import redis
import datetime

# Redis configuration
redis_host = 'cluster-session.***.euc1.cache.amazonaws.com'
redis_port = 6379
redis_password = ''

# S3 configuration
s3_bucket_name = '*****-redis-sessions-debug'

def handler(event, context):
    # Connect to Redis
    client = redis.StrictRedis(
        host=redis_host,
        port=redis_port,
        password=redis_password,
        decode_responses=True
    )

    # Get all keys from Redis
    keys = client.keys('*')

    # Find the biggest key by size
    biggest_key = ''
    biggest_size = 0
    for key in keys:
        size = client.strlen(key)
        if size > biggest_size:
            biggest_key = key
            biggest_size = size

    # Get the value of the biggest key
    value = client.get(biggest_key)

    # Generate a dynamic filename based on the current date and time
    current_time = datetime.datetime.now().strftime('%Y-%m-%d_%H-%M')
    filename = f'{current_time}.txt'

    # Upload the value as a file to S3
    s3 = boto3.resource('s3')
    s3_object = s3.Object(s3_bucket_name, filename)
    s3_object.put(Body=value)

    # Disconnect from Redis
    client.close()

    return 'Success'
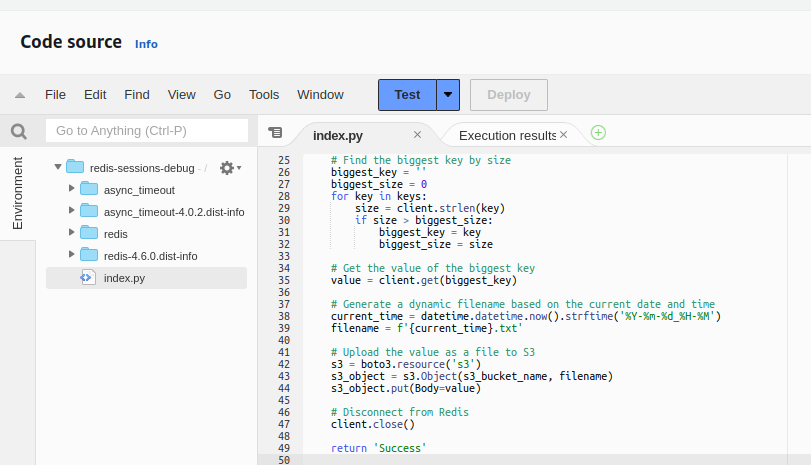
The above code will be executed upon a cloudwatch alert (in our case redis cluster memory utilization above a certain threshold). Lambda will then be triggered and will connect to that redis cluster, list all keys and find the one with the biggest value. Then it will copy the value as a text file and send it to an s3 bucket for further dev review. The file itself is named using the current date time.
zip -r redis-debug.zip .
upload the zip file in Lambda runtime: python 3.10 on arm64 infra allowed ram: 2056 MB max execution time: 1min or more depending on how busy your redis cluster is remember to run lambda in a vpc and give it the appropriate permissions to write to the required s3 bucket
Docker Buildx est une extension de Docker qui permet de créer des images Docker pour plusieurs plates-formes, y compris des plates-formes d’architecture différentes. Il permet également de créer des images pour plusieurs architectures à la fois, ce qui facilite la création de conteneurs Docker multi-plateformes.
Les commandes ci-dessus créent un environnement de build pour la plate-forme arm64. La commande « docker buildx create –name arm64 –platform linux/arm64 » crée un environnement de build nommé « arm64 » avec la plate-forme Linux/arm64 configurée. La commande « docker buildx inspect arm64 –bootstrap » configure l’environnement de build pour utiliser la plate-forme arm64. La commande « docker buildx use arm64 » active l’environnement de build pour la plate-forme arm64.
Enfin, la commande « docker run –rm –privileged multiarch/qemu-user-static –reset -p yes » configure l’environnement pour utiliser QEMU, un émulateur de processeur, pour exécuter des binaires de différentes architectures. Cela permet de construire des images Docker pour des plates-formes d’architecture différentes, même si l’hôte de build ne prend pas en charge ces plates-formes directement.
Cette directive de configuration Nginx détermine comment le serveur proxy doit traiter les erreurs renvoyées par les serveurs de destination lors de la transmission de la requête du client.
Les erreurs de type « timeout », « invalid_header », « http_500 », « http_502 », « http_503 », « http_504 », « http_429 » sont considérées comme des erreurs temporaires et ne sont pas renvoyées directement au client. Au lieu de cela, Nginx essaie de renvoyer la requête à un autre serveur de destination.
Les erreurs « non_idempotent » sont des erreurs permanentes et sont renvoyées directement au client. Les requêtes « non-idempotentes » sont celles qui ne peuvent pas être répétées plusieurs fois sans provoquer de résultats indésirables ou différents.
En utilisant cette directive, on peut configurer Nginx pour qu’il gère les erreurs de manière à minimiser les temps d’arrêt et les erreurs pour les clients qui accèdent aux serveurs proxy.